这回真不是吹。蚂蚁数科刚甩出来的LingDT-Decision-1.0,27B版本在23项开源评测里综合得分第一,直接把微软Decision-1、Jev 1.13.0这些老面孔甩在身后——不是并列,是断层领先。更狠的是,它干的活儿比别人准,花的钱还少:在客服场景里,Token用量砍掉90%,响应快了一倍;在数据标注这种“磨人”任务里,Token直降97%,速度飙了10倍。说白了,它不跟你绕弯子写小作文,就盯着“选哪个、排哪步、判对错”猛攻。
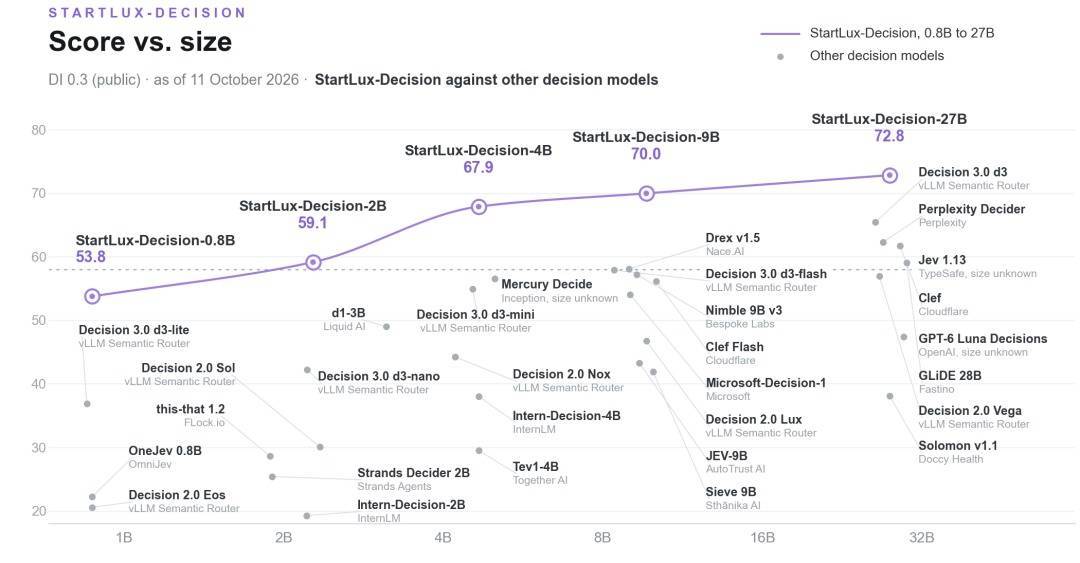
为啥这么猛?因为它压根就不是冲着“生成文本”去的。传统大模型接到一句“订单三天没发货”,得先理解、再组织语言、再输出结构化结果,最后还得靠下游程序去解析——链路长、易出错、费Token。LingDT-Decision-1.0反手一个“原生多选+按序决策(DAG)”,用户一句话进来,它直接输出:问题类型=催单、紧急度=高、归属部门=物流组、是否转人工=否。四个判断一步到位,不废话、不翻车、不浪费。
它已经不是实验室玩具了。蚂蚁自家的智能客服、风控系统、金融审批流里都在跑实测。风险识别准确率从76%拉到89%,幻觉召回率从44%涨到70%,工具调用匹配率翻了2.6倍。4B和27B两个版本,小企业能跑轻量版,大机构敢上重载版。现在模型已上DTMaaS平台,开发者限时免费试用——不用等PPT,今天就能搭进业务里。
别光盯着“27B”这个数字猛吹,真正让工程师拍大腿的是它把决策链路从“黑盒”变成了“透明流水线”。以前调一个风控模型,得反复喂数据、调阈值、看日志猜哪步出岔子;现在LingDT-Decision-1.0输出的每一步判断都带置信度和依据溯源——比如判定“订单异常”时,会同步标出触发依据是“同一IP 1小时内下单5次+收货地址模糊”,连运营同学都能看懂逻辑。这可不是噱头,蚂蚁内部实测显示,模型上线后,一线算法同学排查误判的时间平均缩短了63%,人力直接省在刀刃上。
更实在的是它不挑食。不硬塞你一套新架构,也不逼你重写API。现有系统只要能接HTTP请求、能传JSON,就能把LingDT当“智能开关”插进去。某城商行用4B版本嵌进信贷审批流程,只改了3个接口,两天就跑通全流程测试;一家做电商客服SaaS的创业公司,拿它替换原有规则引擎,客户投诉率降了22%,而服务器成本反而少了三成——因为不再需要为“生成解释话术”预留大量GPU资源。
当然,它也有边界。不碰图像识别,不写长篇报告,不编故事讲道理。蚂蚁数科技术负责人在QCon分享时说得直白:“我们不做万金油,就专注把‘决策’这件事做到毫米级精准。”这话听着低调,但翻看Hugging Face开源页的issue区,已经有超过170个企业用户自发提交了适配金融、物流、政务等场景的prompt模板和微调方案。不是厂商推着走,是真实业务在倒逼进化。
说到底,AI不是越“大”越好,而是越“准”越值钱。当别人还在比谁家模型参数多、谁家幻觉少一点,蚂蚁数科已经把“少犯错、快响应、省资源”这三个老板最在乎的指标,焊死在模型基因里。免费试用期到6月30号,链接就在DTMaaS官网首页——别光截图转发,真想试试,今晚下班前搭个demo,明早晨会就能拿结果说话。
恒盛智投提示:文章来自网络,不代表本站观点。